OpenAI escolhe servidores AMD com 1,5 TB para seu próprio chip de IA | Divulgação/AMD
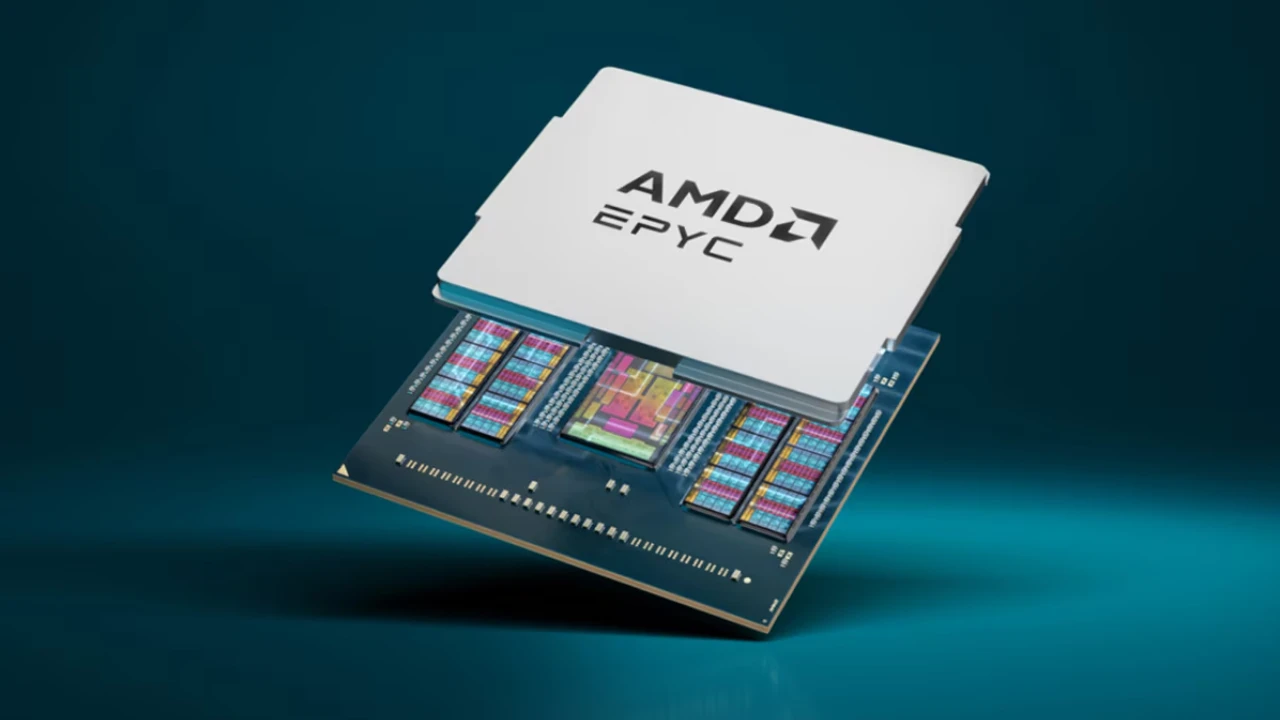
A OpenAI escolheu processadores AMD EPYC Turin para trabalhar ao lado do Jalapeño, seu primeiro acelerador próprio de inteligência artificial. A arquitetura impressiona também pela quantidade de memória: cada bandeja de servidores host utiliza 1,5 TB de DRAM, além de dois processadores da AMD.
A escolha chama atenção porque a OpenAI avaliou a Nvidia Vera, CPU desenvolvida justamente para a nova geração de sistemas de inteligência artificial. Mesmo assim, preferiu manter a primeira implantação do Jalapeño sobre uma plataforma x86 mais madura e conhecida pelos parceiros envolvidos no projeto.
Segundo Richard Ho, vice-presidente e chefe de hardware da OpenAI, a decisão foi essencialmente pragmática. A empresa queria reduzir riscos enquanto colocava em operação seu primeiro ASIC próprio, evitando introduzir várias tecnologias inéditas ao mesmo tempo.
Os 1,5 TB não ficam dentro dos processadores AMD
Há uma distinção técnica importante. Os 1,5 TB correspondem à memória DRAM total de cada bandeja host, e não à memória integrada em cada processador AMD.
A arquitetura descrita para o Jalapeño utiliza dois EPYC Turin em uma bandeja que recebeu internamente o nome de Katsu. Além dos processadores e da enorme quantidade de memória, cada Katsu conta com unidades de armazenamento e conexão de rede frontal de 400 Gb/s.
Essas máquinas funcionam como hosts dos aceleradores desenvolvidos pela OpenAI, cuidando das tarefas que continuam dependendo de CPUs convencionais enquanto os Jalapeños executam os cálculos mais pesados de inteligência artificial.
Jalapeño não elimina a necessidade de CPUs
O Jalapeño é um acelerador dedicado principalmente à inferência de grandes modelos, mas um sistema desse porte continua precisando de processadores generalistas para manter toda a infraestrutura funcionando.
As CPUs administram sistema operacional, preparação e movimentação de dados, comunicação, armazenamento, serviços de rede e processos auxiliares. Também ajudam a garantir que os aceleradores recebam dados suficientemente rápido para não desperdiçar capacidade computacional.
Por isso, o rack não é formado apenas por chips Jalapeño. Existe uma camada completa de servidores trabalhando ao redor dos aceleradores, e é justamente nesse ponto que os AMD EPYC Turin entram na arquitetura.
Um rack host soma 24 TB de DRAM
Cada rack de CPUs reúne 16 bandejas Katsu, e cada uma delas possui 1,5 TB de memória.
A conta chega a 24 TB de DRAM apenas no rack host:
16 × 1,5 TB = 24 TB.
Essa memória não substitui a memória usada diretamente pelos ASICs nos cálculos matriciais. Ela faz parte da infraestrutura que mantém os aceleradores alimentados, coordena os serviços e sustenta todo o ambiente necessário para executar modelos em grande escala.
Outro rack concentra 128 aceleradores Jalapeño
Ao lado dos servidores host ficam as bandejas de aceleradores, chamadas internamente de Vindaloo. Cada uma abriga oito Jalapeños, enquanto um rack completo recebe 16 dessas bandejas.
Isso significa que um rack de aceleradores chega a:
16 × 8 = 128 chips Jalapeño.
Os chips não funcionam de maneira isolada. Eles são interligados por uma infraestrutura própria de rede e switches, permitindo distribuir cargas e ampliar a escala disponível para os modelos.
Até os switches receberam um codinome inspirado em comida: Chana.
Por que a OpenAI escolheu AMD em vez de Nvidia?
A explicação de Richard Ho não passa por uma simples disputa de desempenho bruto. O executivo não disse que os processadores AMD são necessariamente mais rápidos do que tudo o que a Nvidia oferece.
A questão principal foi maturidade.
A geração Turin já estava suficientemente estabelecida, enquanto os parceiros envolvidos no projeto conheciam a plataforma e sabiam como colocá-la em produção. Para uma empresa que tenta estrear simultaneamente um acelerador próprio, sua pilha de software e uma nova arquitetura de data center, reduzir variáveis desconhecidas pode ser mais importante do que adotar a tecnologia mais recente disponível.
Nvidia Vera ainda é uma plataforma recente
A Nvidia Vera utiliza arquitetura Arm e foi criada para trabalhar com os aceleradores Rubin, formando uma plataforma integrada para inteligência artificial.
Entretanto, Ho afirmou que Vera, quando considerada como CPU host independente, ainda estava um pouco atrás no nível de maturidade necessário para a primeira implantação do Jalapeño.
Isso não significa que a OpenAI tenha descartado a plataforma para sempre. A decisão está relacionada à primeira geração do sistema e às necessidades atuais de implantação.
Ao mesmo tempo, a companhia continua pesquisando outras arquiteturas, inclusive Arm. Portanto, a escolha de Turin não determina necessariamente quais CPUs acompanharão futuras gerações de chips próprios.
Jalapeño foi desenvolvido com a Broadcom
O acelerador nasceu de uma parceria entre a OpenAI e a Broadcom. Ele foi apresentado em 2026 como o primeiro processador de inteligência artificial projetado pela própria OpenAI para suas cargas de inferência.
Inferência é a etapa em que um modelo já treinado recebe uma solicitação e produz uma resposta. É o que acontece, por exemplo, quando um usuário conversa com um chatbot, pede geração de conteúdo ou utiliza agentes de inteligência artificial.
Ao desenvolver seu próprio ASIC, a OpenAI pode adaptar o hardware às características específicas de seus modelos e de sua infraestrutura, em vez de depender exclusivamente de aceleradores genéricos oferecidos por terceiros.
Projeto avançou do desenho à produção inicial em nove meses
Segundo OpenAI e Broadcom, o Jalapeño passou do projeto inicial à produção em aproximadamente nove meses, um intervalo bastante curto para um chip dessa complexidade.
A própria inteligência artificial participou do processo. Modelos da OpenAI foram utilizados para auxiliar engenheiros em algumas etapas do desenvolvimento, dentro de uma estratégia de integração entre hardware, modelos e software.
A ideia é fazer com que esses componentes evoluam juntos. Em vez de desenvolver o chip isoladamente e tentar adaptar o software depois, a empresa busca projetar toda a pilha pensando nas cargas que realmente serão executadas.
Chip próprio pode reduzir o custo da inferência
A estratégia não é exclusiva da OpenAI. Google possui TPUs, Amazon desenvolve Trainium e Inferentia, enquanto a Microsoft criou a família Maia.
O motivo vai além de independência tecnológica.
Uma empresa que conhece profundamente seus próprios modelos pode construir hardware otimizado para determinadas operações, eliminando recursos menos úteis e dedicando mais área do chip àquilo que realmente pesa em suas cargas.
Em escala de bilhões de solicitações, pequenas melhorias em consumo de energia, latência, utilização do hardware e throughput podem representar economias enormes.
OpenAI afirma que Jalapeño é mais eficiente
Nos primeiros resultados divulgados, a OpenAI afirma que seu acelerador alcança maior throughput por quilowatt e menor latência por token em determinados cenários de inferência.
Esses dados, porém, precisam ser interpretados dentro de suas condições específicas. Benchmark de inteligência artificial varia conforme modelo, precisão, software, tamanho dos lotes, sequência utilizada e arquitetura concorrente.
Portanto, os números não significam automaticamente que Jalapeño seja mais rápido do que qualquer GPU da Nvidia em qualquer situação.
A relevância está em outro ponto: um chip de primeira geração já consegue apresentar desempenho competitivo em cargas para as quais foi desenvolvido especificamente.
Software será tão importante quanto o silício
A SemiAnalysis também teve acesso ao sistema e executou seu benchmark InferenceX. A avaliação concluiu que Jalapeño apresenta resultados competitivos mesmo numa fase em que a pilha de software ainda está amadurecendo.
Esse é um desafio fundamental para qualquer novo acelerador.
Um chip extremamente rápido perde boa parte de seu valor se os programas não conseguem explorá-lo corretamente. Foi justamente em software que a Nvidia construiu uma vantagem enorme com CUDA ao longo de muitos anos.
A OpenAI, portanto, não precisa apenas fabricar um bom ASIC. Precisa também desenvolver rapidamente ferramentas, compiladores, bibliotecas e sistemas capazes de utilizá-lo em larga escala.
OpenAI pretende usar o chip primeiro dentro de casa
O Jalapeño não foi criado, pelo menos inicialmente, para aparecer nas prateleiras de lojas.
A prioridade é atender à própria infraestrutura da OpenAI, que precisa de uma quantidade crescente de capacidade computacional para sustentar seus modelos e serviços.
Richard Ho já indicou que o acelerador é programável e não está preso a um único modelo. Testes também mostram que a arquitetura consegue executar modelos desenvolvidos por outras organizações.
Mesmo assim, a enorme demanda interna da empresa deve absorver a produção durante bastante tempo.
Produção deve acelerar em 2027
O programa ainda está no começo de sua implantação. A expectativa é aumentar gradualmente a produção durante 2027, com maior volume na parte final do ano.
A parceria com a Broadcom é muito mais ampla do que uma única geração de chips. As empresas planejam implantar 10 gigawatts de aceleradores projetados pela OpenAI ao longo dos próximos anos, com expansão prevista até 2029.
Nesse contexto, Jalapeño funciona menos como um produto isolado e mais como a primeira peça de uma estratégia de longo prazo.
AMD aparece em vários pontos da infraestrutura da OpenAI
A presença da AMD também não termina nas CPUs host.
OpenAI e AMD possuem um acordo separado para implantação de 6 gigawatts de GPUs Instinct, começando por uma primeira fase baseada na série MI450.
Isso mostra como a empresa está diversificando sua infraestrutura. Em vez de depender de um único fornecedor, poderá combinar:
chips próprios, CPUs AMD, GPUs AMD, aceleradores Nvidia e diferentes provedores de nuvem.
Essa diversificação amplia capacidade de negociação, reduz riscos de escassez e oferece mais flexibilidade para escolher a arquitetura mais adequada a cada carga.
Isso significa que a OpenAI está abandonando a Nvidia?
Não.
A escolha de EPYC Turin para os servidores do Jalapeño não representa uma ruptura com a Nvidia. A OpenAI continua operando uma infraestrutura enorme baseada em GPUs da empresa e deverá continuar utilizando diferentes gerações desses aceleradores.
O que está acontecendo é uma redução da dependência de qualquer fornecedor isolado.
À medida que o consumo de computação cresce, torna-se arriscado depender exclusivamente de uma única empresa para CPUs, aceleradores, rede e software.
Por que um servidor precisa de 1,5 TB de RAM?
Em um computador doméstico, 1,5 TB de memória parece uma quantidade quase absurda. Em um sistema que precisa alimentar dezenas ou centenas de aceleradores de inteligência artificial, a lógica é diferente.
Os servidores host precisam manter buffers, dados de entrada, caches, estados de aplicações, processos auxiliares e estruturas de comunicação. Além disso, têm de entregar informações em ritmo suficiente para evitar que chips extremamente caros fiquem parados esperando por dados.
Nesse tipo de infraestrutura, memória não serve apenas para “caber um modelo”. Ela faz parte da capacidade geral de manter o sistema inteiro trabalhando de maneira eficiente.
CPU também virou parte da corrida da inteligência artificial
Durante os últimos anos, quase toda a atenção do mercado ficou concentrada nas GPUs. Entretanto, treinamento e inferência dependem de uma combinação muito mais ampla:
CPU + memória + aceleradores + rede + armazenamento + software.
Com agentes mais complexos, serviços permanentes e cargas distribuídas, a CPU volta a ganhar protagonismo dentro dos data centers de IA.
É por isso que a Nvidia desenvolveu Vera, a AMD continua ampliando EPYC e empresas como OpenAI analisam cuidadosamente qual arquitetura será responsável por alimentar seus próprios aceleradores.
Os 1,5 TB revelam a verdadeira escala da IA
A manchete “OpenAI escolheu AMD em vez de Nvidia” conta apenas uma pequena parte da história.
O dado mais revelador talvez seja a própria dimensão do sistema. Cada bandeja host utiliza dois EPYC Turin e 1,5 TB de DRAM, enquanto 16 dessas bandejas trabalham ao lado de um rack que reúne 128 aceleradores Jalapeño.
Somam-se a isso redes de centenas de gigabits, switches dedicados, armazenamento e uma pilha de software criada para fazer tudo trabalhar em conjunto.
O acelerador pode ser a estrela do sistema, mas uma infraestrutura dessa escala deixa claro que cada resposta produzida por uma inteligência artificial depende de muito mais hardware do que apenas o chip que executa os cálculos principais.